
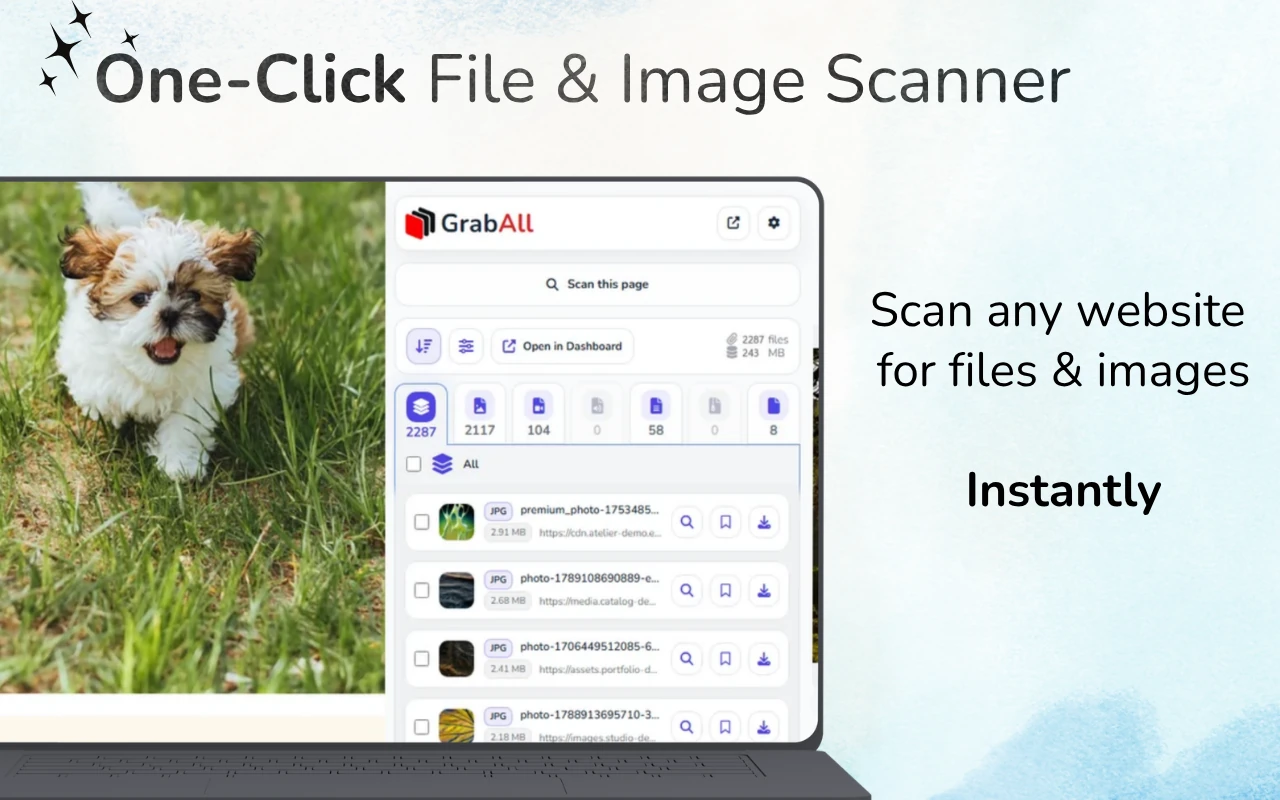
Szybka odpowiedź: Otwórz stronę internetową, załaduj odpowiednią treść i zeskanuj ją za pomocą GrabAll. Przefiltruj wykryte pliki według typu lub rozmiaru, sprawdź podglądy i nazwy plików, a następnie zapisz lub skopiuj wybrane linki. Niektóre zasoby pojawiają się dopiero po interakcji ze stroną.
Szukaj linków do plików na załadowanej stronie
Przyciski pobierania, listy dokumentów, karty z obrazami i elementy multimedialne mogą ujawniać pliki. Zacznij od załadowania sekcji zawierającej zasoby, następnie zeskanuj i przejrzyj wyniki. Skaner może wylistować tylko zasoby dostępne dla przeglądarki.
Co liczy się jako plik do pobrania
Plik do pobrania może być powiązanym dokumentem, źródłem obrazu, elementem multimedialnym, archiwum, arkuszem kalkulacyjnym lub innym publicznym zasobem odwoływanym przez stronę. Przeglądarka musi posiadać wystarczającą wiedzę o zasobie, aby móc o niego poprosić lub go wyświetlić.
Odkrywanie plików nie oznacza eksploracji serwera. GrabAll działa z bieżącą stroną i dostarczonymi adresami URL, a nie z prywatnymi katalogami ani nieudostępnionymi zawartościami serwera.
- Odnośniki kotwic do dokumentów i archiwów
- Atrybuty src, srcset i lazy-load obrazów
- Elementy wideo, audio, plakaty i źródła
- Publiczne adresy URL plików obecne w tekście strony lub atrybutach danych
Ustrukturyzowany proces odkrywania
Najpierw skanuj najbardziej istotną stronę. Grupuj wyniki według typu, a następnie sprawdzaj rozszerzenia plików, wskazówki MIME, wymiary, rozmiary i domeny źródłowe. Korzystaj z podglądów tam, gdzie są dostępne.
Jeśli strona jest dynamiczna, pozwól, aby odpowiednia sekcja załadowała się przed skanowaniem. Unikaj przewijania przez niepowiązane obszary, ponieważ może to dodać rekomendacje i elementy nawigacyjne do zestawu wyników.
- Wybierz konkretną stronę
- Załaduj treść istotną dla zadania
- Skanuj i grupuj wyniki według typu
- Filtruj, przeglądaj i wybieraj przydatne pliki
URL-e bez oczywistych rozszerzeń
Niektóre pobrania wykorzystują ścieżki takie jak /download?id=123 zamiast nazw plików kończących się na .pdf lub .zip. Takie linki mogą być trudniejsze do sklasyfikowania przed odpowiedzią serwera. Etykiety stron, nagłówki odpowiedzi i zachowanie przeglądarki przy pobieraniu mogą dostarczyć więcej informacji.
Nie zakładaj, że każdy długi URL to plik. Linki śledzące, nawigacyjne i API mogą wyglądać podobnie.
Kiedy skanowanie jest lepsze niż oglądanie źródła
Przeglądanie źródła HTML może pomóc użytkownikom technicznym, ale nowoczesne strony często dodają zawartość po załadowaniu pierwszego dokumentu. Rozszerzenie przeglądarki może przeglądać renderowany kontekst i prezentować wyniki w interfejsie zorientowanym na recenzje.
Dla wklejonego HTML lub źródła offline, użyj darmowego Bulk File URL Extractor. Dla aktywnej strony, użyj GrabAll, aby połączyć wykrywanie z podglądem i wyborem pobierania.
Ustal realistyczne oczekiwania
Pliki chronione uwierzytelnianiem, generowane po wywołaniach chronionego API, przechowywane w prywatnych systemach lub dostarczane przez DRM są poza zakresem normalnego skanera stron. Szanuj zasady dostępu i korzystaj z oficjalnych opcji pobierania, jeśli są udostępnione.
Najlepsze wyniki osiągają strony, które celowo udostępniają linki do zasobów, galerie, załączniki, dokumenty lub zwykłe pliki multimedialne.
Najczęściej zadawane pytania
Czy GrabAll może znaleźć pliki, które nie są podlinkowane na stronie?
Nie. Organizuje zasoby i linki dostępne w przeglądarce; nie przeszukuje prywatnych katalogów serwera ani nie ujawnia nieudostępnionych plików.
Czy powinienem zeskanować stronę główną, czy konkretną stronę?
Użyj najbardziej szczegółowej strony. Generuje mniej niepowiązanych zasobów i czystsze wyniki.
Co jeśli URL nie ma rozszerzenia pliku?
Może nadal generować pobieranie, ale klasyfikacja jest mniej niezawodna, dopóki serwer nie odpowie. Przejrzyj etykietę strony i użyj oficjalnego sterowania w przypadku wątpliwości.
Czy mogę zamiast tego wyodrębnić linki z kopiowanego HTML?
Tak. GrabAll oferuje bezpłatny ekstraktor zbiorczy adresów URL plików dla wklejonego HTML, kodu źródłowego i tekstu.
GrabAll skanuje stronę i zbiera obrazy, dokumenty, media oraz inne pliki do pobrania w jednej czytelnej liście, abyś mógł dokładnie wybrać, co zapisać.