
Szybka odpowiedź: Przygotuj adresy URL stron, które chcesz zeskanować, zaimportuj je do GrabAll Premium i uruchom Masowe Skanowanie. Przejrzyj linki do plików znalezione na tych stronach, przefiltruj wyniki i pobierz wybrane pliki. Dostarczona lista kontroluje, które strony są skanowane.
Użyj listy URL-i stron do skanowania wsadowego
Adres URL strony wskazuje na stronę internetową do zeskanowania; bezpośredni adres URL pliku wskazuje na sam plik. Przygotuj swoją listę wokół stron zawierających potrzebne zasoby. GrabAll nie odkrywa automatycznie wszystkich stron w domenie, więc uwzględnij odpowiednie strony wprost.
Zacznij od czystej listy adresów URL
Usuń puste linie, duplikaty, fragmenty, parametry śledzenia i oczywiste URL-e nawigacyjne. Zachowaj jeden URL na linię i używaj pełnych adresów HTTPS, jeśli to możliwe.
Darmowy URL List Cleaner GrabAll może usuwać duplikaty i sortować wklejone listy przed użyciem ich w większym workflow.
- Jeden pełny URL na linię
- Brak duplikatów lub nieistotnych stron
- Spójny format protokołu i domeny
Podziel duże projekty na logiczne partie
Grupuj adresy URL według strony internetowej, kategorii, klienta, daty lub typu zasobu. Partia powiązanych stron daje wyniki, które łatwiej filtrować i nazwać niż jedna mieszana lista z wielu niepowiązanych źródeł.
Zacznij od małej próbki, aby potwierdzić, że strony udostępniają oczekiwane pliki. Skaluj partię dopiero po uzyskaniu użytecznych rezultatów z próbki.
- Przetestuj niewielką reprezentatywną próbę
- Grupuj podobne adresy URL razem
- Ustaw praktyczny rozmiar partii
- Zapisuj osobno nieudane lub przekierowane strony
Obsługuj przekierowania, błędy i strony dynamiczne
Niektóre URL-e przekierowują, wymagają uwierzytelnienia, zwracają błędy lub ładują ważną zawartość dopiero po interakcji. Traktuj je jako wyjątki, zamiast ponownie skanować całą listę.
Jeśli strona wymaga ręcznej sesji lub wizualnej weryfikacji, przenieś ją do przepływu pracy w otwartej karcie. Importowane skanowanie jest najskuteczniejsze w przypadku stabilnych stron bezpośrednio dostępnych.
Przeglądaj pliki z wielu źródeł
Połączone wyniki mogą zawierać wspólne logotypy, powtarzające się pobrania, miniatury oraz ten sam dokument powiązany z kilku stron. Filtruj według typu i rozmiaru, a następnie usuwaj duplikaty według URL i widocznych metadanych.
Zachowaj kopię listy wejściowej i wyeksportowanych linków przed pobraniem. Tworzy to powtarzalny zapis, jeśli wsadowe sprawdzenie będzie konieczne później.
Bądź uprzejmy wobec automatycznych partii
Duże skany tworzą zapytania do stron internetowych. Trzymaj partie w rozsądnych granicach, unikaj niepotrzebnego powtarzania i zatrzymaj się, jeśli strona pokaże limity lub poprosi o użycie innej metody dostępu.
Najczęściej zadawane pytania
Jak powinienem sformatować zaimportowaną listę URL?
Użyj jednej pełnej HTTP lub HTTPS URL-u w każdym wierszu, usuń duplikaty i skup listę na stronach związanych z jednym zadaniem.
Dlaczego najpierw testować małą próbkę?
Przykład potwierdza, że typ strony udostępnia użyteczne pliki i pomaga wybrać filtry przed przetwarzaniem większej partii.
Co powinienem zrobić ze stronami wymagającymi interakcji?
Przenieś je do trybu pracy w otwartej karcie, gdzie możesz ręcznie załadować i potwierdzić zawartość przed skanowaniem.
Czy skanowanie URL omija uwierzytelnianie?
Nie. Działa tylko z stronami i plikami dostępnymi przez dozwolony tryb pracy przeglądarki.
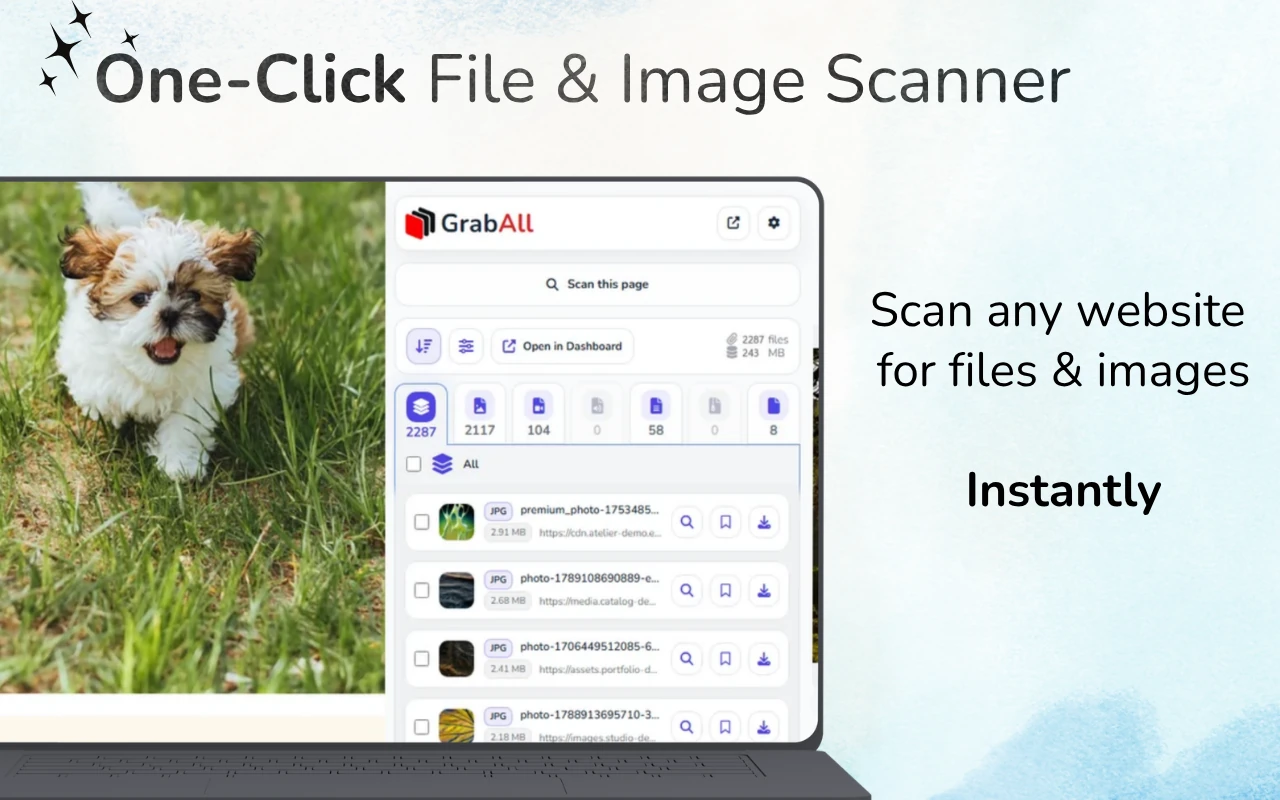
GrabAll skanuje stronę i zbiera obrazy, dokumenty, media oraz inne pliki do pobrania w jednej czytelnej liście, abyś mógł dokładnie wybrać, co zapisać.