

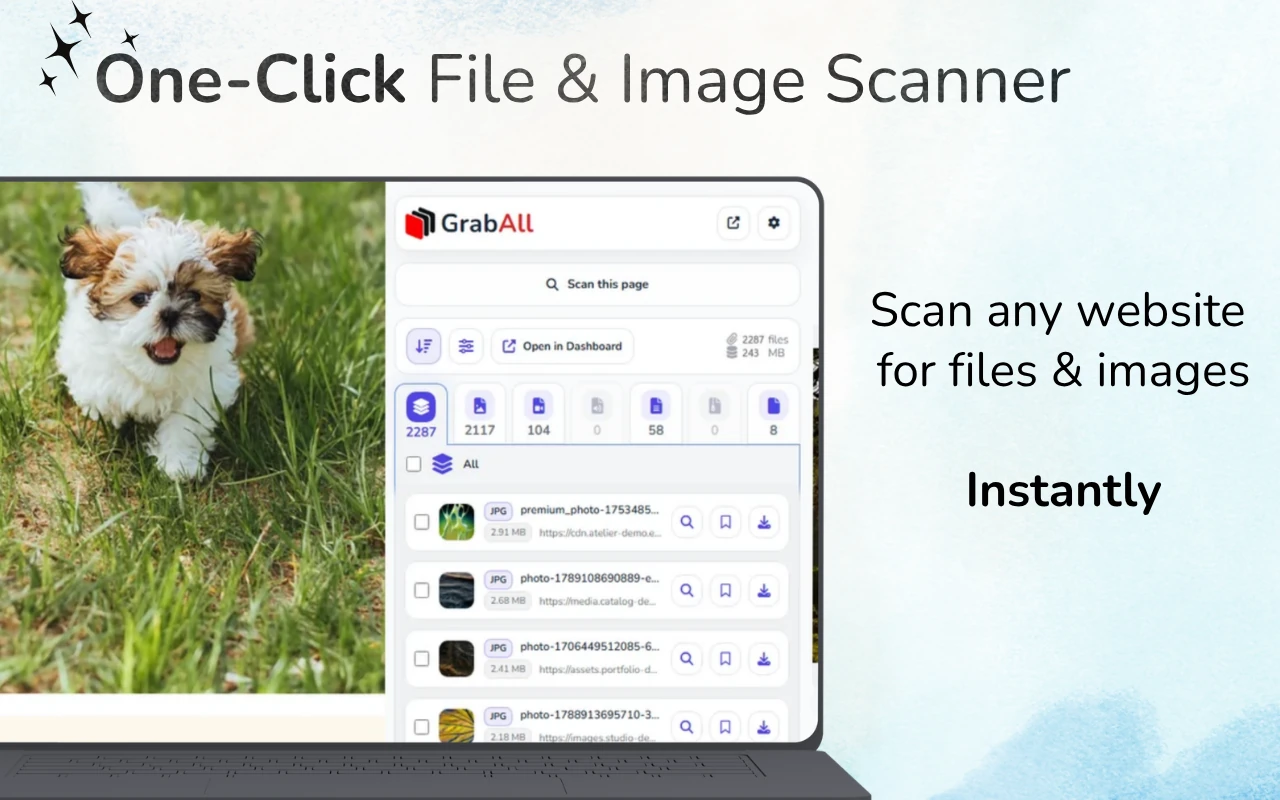
Rýchla odpoveď: Otvorte webovú stránku, načítajte relevantný obsah a skenujte ho pomocou GrabAll. Filtrovať zistené súbory podľa typu alebo veľkosti, skontrolujte náhľady a názvy súborov, potom uložte alebo skopírujte vybrané odkazy. Niektoré zdroje sa zobrazia až po interakcii so stránkou.
Hľadať odkazy na súbory na načítanej stránke
Tlačidlá na stiahnutie, zoznamy dokumentov, obrazové karty a mediálne prvky môžu všetky odhaliť súbory. Začnite načítaním sekcie obsahujúcej zdroje, potom skenujte a skontrolujte výsledky. Skenovač môže zoznamovať iba zdroje, ktoré stránka sprístupní prehliadaču.
Čo sa počíta ako súbor na stiahnutie
Súbor na stiahnutie môže byť prepojený dokument, zdroj obrázka, mediálny prvok, archív, tabuľka alebo iný verejný zdroj, na ktorý stránka odkazuje. Prehliadač musí o zdroji vedieť dosť na to, aby ho mohol požiadať alebo zobraziť.
Objavovanie súborov neznamená prieskum servera. GrabAll pracuje s aktuálnou stránkou a poskytnutými URL, nie so súkromnými adresármi alebo nezverejneným obsahom serverov.
- Odkazy na dokumenty a archívy
- Atribúty src, srcset a lazy-load pre obrázky
- Video, audio, poster a zdrojové prvky
- Verejné URL súborov prítomných v texte stránky alebo atribútoch dát
Štruktúrovaný objavovací proces
Najskôr prejdite najrelevantnejšiu stránku. Zoskupte výsledky podľa typu, potom skontrolujte prípony súboru, MIME nápovedy, rozmery, veľkosti a zdrojové domény. Použite náhľady, kde sú dostupné.
Ak je stránka dynamická, počkajte, až sa načíta príslušná časť pred skenovaním. Vyhnite sa posúvaniu cez nesúvisiace oblasti, pretože to môže do výsledkov pridať odporúčania a navigačné prvky.
- Vyberte konkrétnu stránku
- Načítať obsah relevantný k úlohe
- Skenovanie a zoskupenie výsledkov podľa typu
- Filtrovať, prezerať a vyberať užitočné súbory
URL adresy bez zjavnej prípony
Niektoré sťahovania používajú cesty ako /download?id=123 namiesto súborových mien končiacich na .pdf alebo .zip. Tieto odkazy môže byť ťažšie klasifikovať pred odpoveďou servera. Popisky stránok, hlavičky odpovedí a správanie prehliadača pri sťahovaní môžu poskytnúť viac informácií.
Nepredpokladajte, že každý dlhý odkaz je súbor. Sledovacie, navigačné a API odkazy môžu vyzerať podobne.
Kedy je skenovanie lepšie ako zobrazenie zdroja
Prezeranie zdroja HTML môže pomôcť technickým používateľom, ale moderné stránky často pridávajú obsah po načítaní pôvodného dokumentu. Rozšírenie prehliadača môže skontrolovať rendrovaný kontext a zobraziť výsledky v rozhraní orientovanom na kontrolu.
Pre vložený HTML alebo offline zdroj použite bezplatný Bulk File URL Extractor. Pre živú stránku použite GrabAll, aby ste mohli kombinovať objavovanie s náhľadmi a výberom stiahnutia.
Nastavte realistické očakávania
Súbory za autentifikáciou, generované po chránených API volaniach, uložené v súkromných systémoch alebo doručené cez DRM, sú mimo rozsahu bežného skenera stránok. Rešpektujte pravidlá prístupu a používajte oficiálne kontroly sťahovania, kde sú k dispozícii.
Najlepšie výsledky prinášajú stránky, ktoré úmyselne vystavujú odkazy na zdroje, galérie, prílohy, dokumenty alebo bežné mediálne súbory.
Často kladené otázky
Dokáže GrabAll nájsť súbory, ktoré nie sú prepojené na stránke?
Nie. Organizuje zdroje a odkazy dostupné prehliadaču; nevyhľadáva súkromné serverové adresáre ani neodhaľuje nezverejnené súbory.
Mám skenovať domovskú stránku alebo konkrétnu stránku?
Použite čo najšpecifickejšiu stránku. Produkuje menej nesúvisiacich aktív a čistejšie výsledky.
Čo ak URL nemá príponu súboru?
Môže stále spustiť sťahovanie, ale klasifikácia je menej spoľahlivá, kým server neodpovie. Skontrolujte označenie stránky a používajte oficiálnu kontrolu, ak si nie ste istí.
Môžem namiesto toho extrahovať odkazy z kopírovaného HTML?
Áno. GrabAll poskytuje bezplatný Bulk File URL Extractor pre vložené HTML, zdrojový kód a text.
GrabAll prehľadáva stránku a prináša obrázky, dokumenty, médiá a iné stiahnuteľné súbory do jedného prehľadného zoznamu, aby ste si mohli vybrať presne, čo chcete uložiť.