

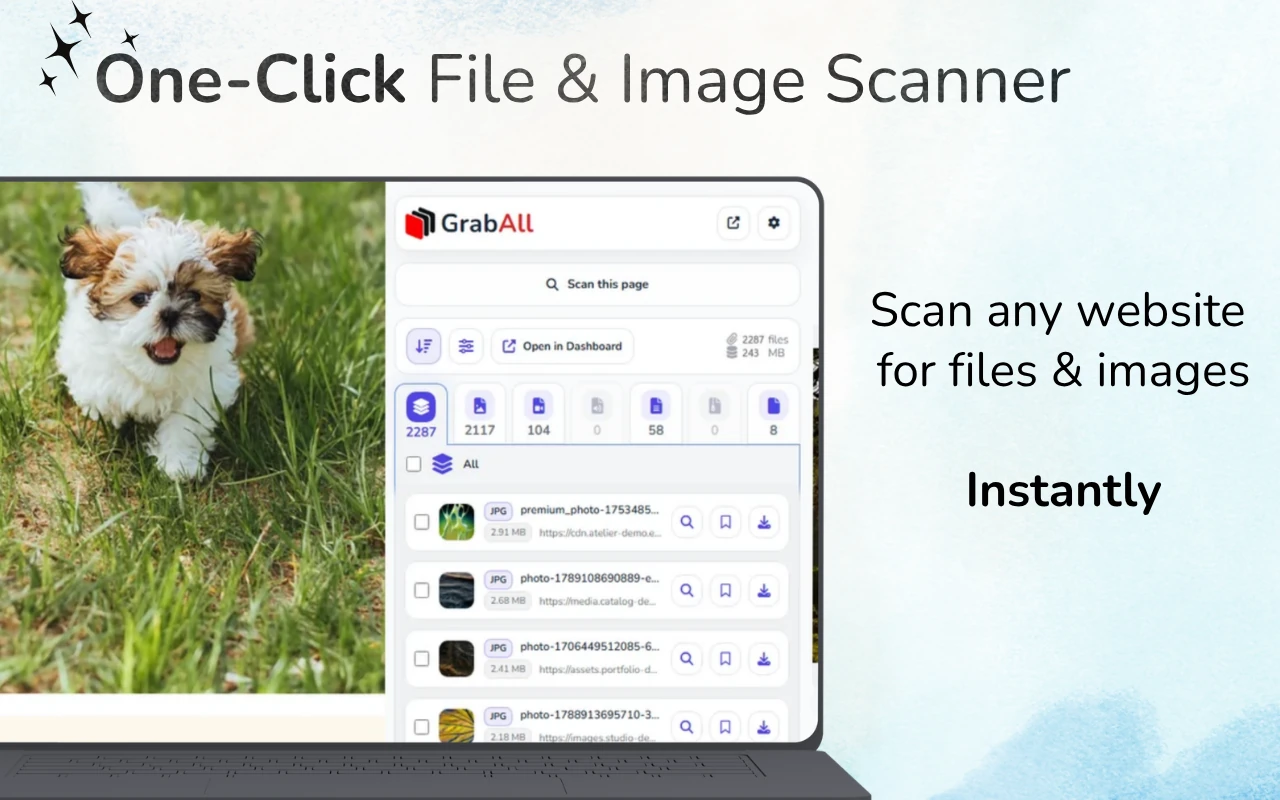
Швидка відповідь: Відкрийте веб-сторінку, завантажте відповідний контент і проскануйте його за допомогою GrabAll. Відфільтруйте виявлені файли за типом або розміром, перевірте попередній перегляд та назви файлів, а потім збережіть або скопіюйте вибрані посилання. Деякі ресурси з'являються лише після взаємодії зі сторінкою.
Шукайте посилання на файли на завантаженій сторінці
Кнопки завантаження, списки документів, картки зображень і медіаелементи можуть відкривати файли. Почніть із завантаження розділу з ресурсами, потім скануйте та переглядайте результати. Сканер може перелічувати лише ті ресурси, які сторінка надає браузеру.
Що вважається файлом для завантаження
Завантажуваний файл може бути пов’язаним документом, джерелом зображення, медіа-елементом, архівом, електронною таблицею або іншим публічним ресурсом, на який посилається сторінка. Браузер повинен знати достатньо про ресурс, щоб запитати або відобразити його.
Виявлення файлів не означає дослідження сервера. GrabAll працює з поточною сторінкою та наданими URL-адресами, а не з приватними каталогами чи вмістом сервера.
- Якірні посилання на документи та архіви
- Атрибути src, srcset і lazy-load зображення
- Відео, аудіо, плакати та джерела
- Публічні URL-адреси файлів, присутні в тексті сторінки або атрибутах даних
Структурований процес виявлення
Спочатку проскануйте найбільш релевантну сторінку. Згрупуйте результати за типом, потім перевірте розширення файлів, підказки MIME, розміри, розміри та домени джерела. Використовуйте попередні перегляди, де це можливо.
Якщо сторінка динамічна, зачекайте завантаження відповідного розділу перед скануванням. Уникайте прокручування непов’язаних ділянок, бо це може додати рекомендації та елементи навігації до набору результатів.
- Вибрати конкретну сторінку
- Завантажте контент, що стосується завдання
- Результати сканування та групування за типом
- Фільтруйте, переглядайте та вибирайте корисні файли
URL без очевидних розширень
Деякі завантаження використовують маршрути на кшталт /download?id=123 замість файлів з розширенням .pdf або .zip. Такі посилання можуть бути важче класифікувати до відповіді сервера. Ярлики сторінок, заголовки відповіді та поведінка завантаження браузера можуть надати більше інформації.
Не вважайте, що кожна довга URL — це файл. Зв'язки для відстеження, навігації та API можуть виглядати схоже.
Коли сканування краще, ніж перегляд джерела
Перегляд вихідного коду HTML може допомогти технічним користувачам, але сучасні сторінки часто додають контент після початкового завантаження документа. Розширення браузера може перевірити відображений контекст і подати результати в інтерфейсі, орієнтованому на перегляд.
Для вставленого HTML або офлайн-коду використовуйте безкоштовний Bulk File URL Extractor. Для живої сторінки використовуйте GrabAll, щоб поєднати виявлення з попереднім переглядом і завантажити вибір.
Встановлюйте реалістичні очікування
Файли, що стоять за автентифікацією, згенеровані після захищених викликів API, збережені в приватних системах або доставлені через DRM, виходять за межі звичайного сканера сторінок. Дотримуйтесь правил доступу та використовуйте офіційні контролі завантаження, якщо це передбачено.
Найкращі результати дають сторінки, які спеціально відкривають посилання на ресурси, галереї, вкладення, документи або звичайні медіафайли.
Поширені запитання
Чи може GrabAll знаходити файли, які не пов'язані на сторінці?
Ні. Він організовує ресурси та посилання, доступні браузеру; він не шукає у приватних директоріях серверів і не відкриває файли, які не були розкриті.
Слід сканувати головну сторінку чи конкретну сторінку?
Використовуйте максимально конкретну сторінку. Вона дає менше непов'язаних ресурсів і чистіші результати.
А якщо URL не має розширення файлу?
Він все ще може створювати завантаження, але класифікація менш надійна, поки сервер не відреагує. Перевірте мітку сторінки та використовуйте офіційний контроль у разі сумнівів.
Чи можу я замість цього витягувати посилання з скопійованого HTML?
Так. GrabAll надає безкоштовний інструмент для масового витягування URL-файлів з вставленого HTML, вихідного коду та тексту.
GrabAll сканує сторінку та збирає зображення, документи, медіа та інші завантажувані файли в один зрозумілий список, щоб ви могли вибрати саме те, що хочете зберегти.