
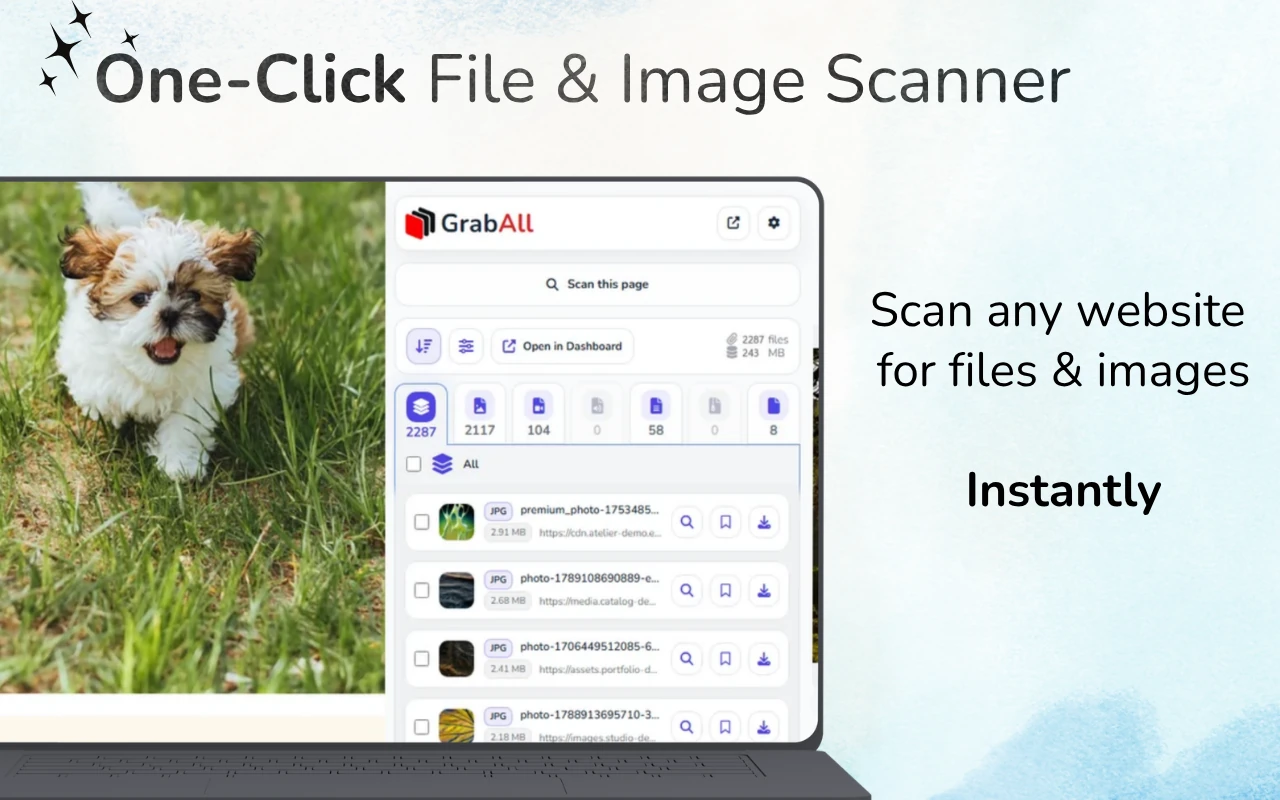
快速回答: 對於即時網頁,使用 GrabAll 掃描並複製檢測到的檔案連結。對於已儲存的 HTML 或複製的原始碼,將其貼入批量檔案 URL 擷取器。如果來源包含相對連結,請提供基礎 URL。
在掃描頁面和解析貼上 HTML 之間選擇
掃描已加載的網頁可以找到瀏覽器中可用的檔案,而線上提取工具僅讀取您粘貼的 HTML 或文字。選擇與您的起點相符的方法,然後在用於下載之前檢查生成的 URL。
檔案 URL 在 HTML 中出現的位置
普通連結使用 href,而圖片和媒體通常使用 src。響應式圖片可以在 srcset 中列出多個候選。延遲載入的程式庫通常把真實 URL 存放在 data-src、data-original 或自定義數據屬性中。
樣式表和內嵌 CSS 可能透過 url() 參考背景。原始文字也可能包含完整 URL,而不附加於 HTML 元素上。
- href 連結
- src 和 poster 屬性
- srcset 和 data-srcset 候選
- CSS url() 值及原始絕對 URL
正確解析相對路徑
像 ../files/report.pdf 這樣的值僅相對於 HTML 來源頁面有意義。提供原始頁面 URL 作為基準,以便擷取器能將相對路徑轉換為完整地址。
以 // 開頭的協定相對連結通常會在安全頁面繼承 HTTPS。以 / 開頭的根路徑使用當前網站的來源。
- 保留原始來源頁面 URL
- 將其作為基礎 URL 使用
- 標準化協議相對路徑和根目錄相對路徑
- 在使用清單前,先檢閱已解析的網域
按意圖篩選候選 URL
源代碼中的每個 URL 並非都是可下載資源。頁面包含導航連結、API、分析工具、字體、腳本、樣式表和追蹤參數。按相關擴展名篩選並檢查模糊 URL。
對於影像,包含現代格式如 WebP 和 AVIF。對於文件,依任務需求考慮 PDF、DOCX、XLSX、CSV、PPTX 以及壓縮檔。
HTML 原始碼與渲染後的頁面
已複製的來源僅代表您提供的內容。可能會缺少 JavaScript 執行後插入的資源、捲動後載入的內容,或互動過程中生成的 URL。
對來源片段、匯出 HTML、電子郵件範本和程式碼審查使用離線擷取器。對實時呈現的頁面與瀏覽器上下文工作流程使用 GrabAll 擴展。
下載前驗證
對列表去重、檢查網域並測試小樣本。URL 中匹配的副檔名並不保證回應有效或您有權使用它。
避免自動請求大量未經審核的清單。驗證可以防止斷鏈、不需要的追蹤端點,以及不必要的負載。
常見問題
擷取器能解析....../ 相對連結嗎?
是的,當您提供原始頁面 URL 作為基地址時。
HTML 提取包含 srcset 圖片嗎?
GrabAll 工具會檢查常見的來源和響應式圖片屬性,包括 srcset 候選項。
為什麼複製的 HTML 中會缺少一些即時頁面的檔案?
JavaScript 可能會在初始 HTML 加載後添加它們。請使用即時瀏覽器擴展以取得渲染及動態加載的頁面內容。
所有擷取的網址都可以安全下載嗎?
不。在使用結果列表之前,請檢查域名、文件類型、權限以及少量示例。
GrabAll 掃描頁面並將圖片、文件、媒體及其他可下載檔案整理成清單,方便你精確選擇要保存的項目。