
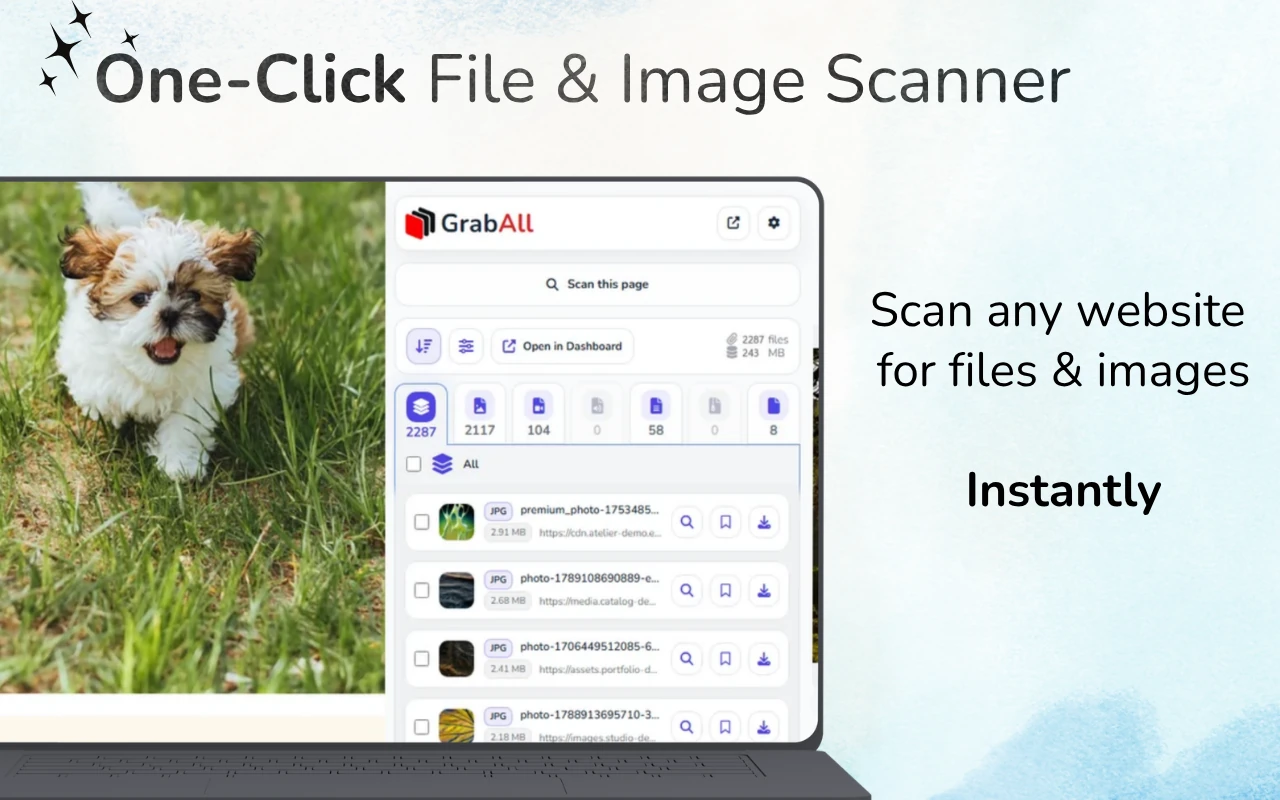
快速回答: 打開網頁,載入相關內容並使用 GrabAll 掃描。按類型或大小篩選檢測到的檔案,檢查預覽和檔名,然後保存或複製選中的連結。有些資源僅在頁面交互後才出現。
查找已載入頁面中的檔案連結
下載按鈕、文件列表、圖片卡片和媒體元素都可能曝光文件。先載入包含資源的區域,然後掃描並檢查結果。掃描器只能列出頁面提供給瀏覽器的資源。
什麼算作可下載檔案
可下載的檔案可以是鏈接文件、影像來源、媒體元素、壓縮檔、試算表,或頁面引用的其他公開資產。瀏覽器必須對資源有足夠了解,以便請求或顯示它。
檔案發現並不等於伺服器探索。GrabAll 僅作用於當前頁面和提供的 URL,而不是私有目錄或未列出的伺服器內容。
- 文件與檔案壓縮檔的錨點連結
- 圖片 src、srcset 和延遲加載屬性
- 影片、音訊、海報及來源元素
- 頁面文字或資料屬性中存在的公開檔案 URL
一個結構化的發現流程
先掃描最相關的頁面。按類型分組結果,然後檢查檔案副檔名、MIME 提示、尺寸、大小及來源網域。使用可用的預覽。
如果頁面是動態的,請在掃描前允許相關區域加載完成。避免滾動瀏覽不相關的區域,因為這可能會將推薦和導航資源加入結果集合。
- 選擇特定頁面
- 載入與任務相關的內容
- 掃描並按類型分組結果
- 篩選、預覽並選擇有用的檔案
沒有明顯擴展名的 URL
一些下載使用像 /download?id=123 這樣的路徑,而不是以 .pdf 或 .zip 結尾的檔名。這些連結在伺服器回應之前可能更難分類。頁面標籤、回應標頭和瀏覽器下載行為可能提供更多資訊。
不要假設每個長 URL 都是文件。追蹤、導航和 API 連結可能看起來相似。
何時掃描比查看原始碼更好
查看 HTML 原始碼可以幫助技術使用者,但現代頁面經常在初始文件載入後添加內容。瀏覽器擴展可以檢查渲染的上下文,並以審查為導向的介面呈現結果。
對於貼上的 HTML 或離線來源,使用免費的批量檔案 URL 擷取器。對於即時頁面,使用 GrabAll,可同時結合檔案發現、預覽和下載選擇。
設置現實的期望
需要驗證、受保護 API 呼叫後生成、存儲於私有系統或透過 DRM 傳遞的檔案,超出普通頁面掃描器的範圍。請遵守存取規則,並在提供官方下載控制時使用。
最佳結果來自刻意公開資源連結、畫廊、附件、文件或一般媒體檔案的頁面。
常見問題
GrabAll 能找到頁面上沒有連結的檔案嗎?
不。它整理瀏覽器可用的資源和連結;它不會搜索私人服務器目錄或顯示未公開的文件。
我應該掃描首頁還是特定頁面?
使用最具體的頁面。它產生較少不相關的資產,結果也更乾淨。
如果 URL 沒有檔案副檔名怎麼辦?
它仍然可能會生成下載,但在伺服器回應之前,分類的可靠性較低。在不確定時,請檢查頁面標籤並使用官方控制項。
我可以從複製的 HTML 中提取連結嗎?
是的。GrabAll 為粘貼的 HTML、源代碼和文本提供免費的批量文件 URL 提取器。