
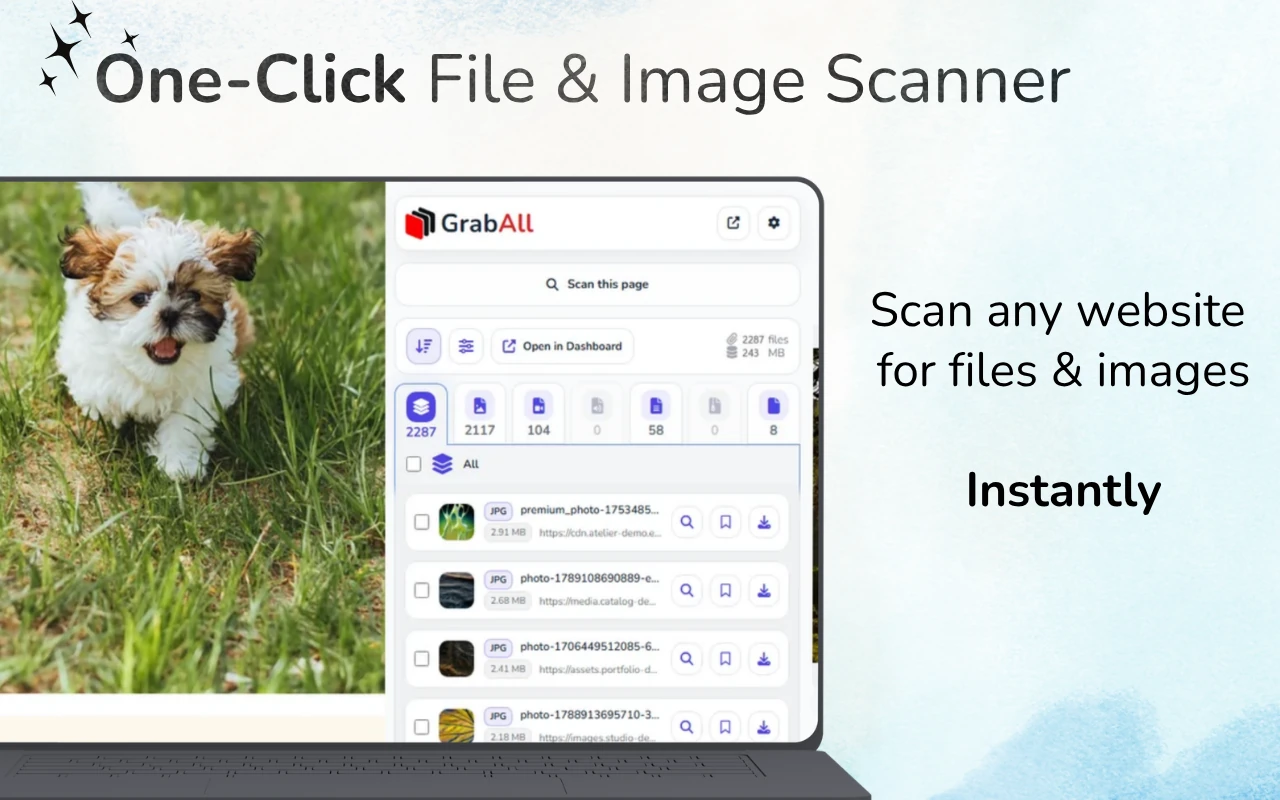
快速回答: 打開包含檔案的頁面,使用 GrabAll 掃描,篩選列表並選擇要下載的檔案。使用高級版可以將選中的檔案單獨保存或打包成 ZIP。如果檔案分佈在多個頁面,使用打開的標籤頁或匯入的 URL 列表掃描這些頁面。
逐步下載網頁中的連結文件
大量檔案下載器會收集頁面上的檔案連結,方便你們一起檢視。從實際列出下載內容的頁面開始,例如資源庫或產品頁面。這會下載選定的檔案;不會建立整個網站的離線副本。
為什麼逐一下載檔案會變得沒有效率
當頁面只包含一個文件或幾個明顯圖片時,手動儲存是合理的。當有用檔案與縮圖、圖示、重複連結、追蹤 URL、響應式圖片變體及無關頁面資源混雜時,速度會變慢。
批量工作流程將尋找檔案與下載檔案分開。你先建立可審查清單,然後決定哪些檔案屬於最終批次。這樣可以避免意外下載,也讓重複這個過程更方便。
- 例如 JPG、PNG、WebP、SVG、GIF 和 AVIF 的圖片
- PDFs、文件、試算表、簡報、CSV 文件與存檔檔案
- 暴露於瀏覽器的直接影片及音訊檔案
- 頁面或提供的 URL 列表中存在的其他公共檔案連結
一個實用的逐步工作流程
打開包含你被允許收集資產的精確頁面。執行 GrabAll,等待掃描完成,並在開始下載前檢查結果。
先使用文件類型篩選器,然後使用大小和圖片解析度篩選器。預覽模糊項目,刪除微小的裝飾性資源,如果想在下載前保留記錄,則複製最終鏈接。
- 掃描當前頁面
- 按檔案類型、大小或圖片尺寸篩選
- 預覽並僅選擇相關結果
- 下載所選的批次或在可用時使用 ZIP 匯出
請選擇正確的掃描模式
當前頁面掃描最適用於單個圖庫、產品頁、資源頁或文件頁。開啟分頁掃描在相同研究任務跨多個頁面時非常有用。匯入 URL 掃描則針對需要可重複批次工作流程的預備清單而設計。
從最小的有用範圍開始。掃描較少但精選的頁面能產生更乾淨的結果集並減少重複檔案。
文件缺失的常見原因
可見按鈕並不總是指向直接檔案。一些網站在 API 請求後生成下載,需經過授權的會話,或透過分段格式串流媒體。掃描器可以整理瀏覽器可用的資源,但無法製造頁面從未公開的公共檔案 URL。
如果結果缺失,請確認文件在當前瀏覽器會話中能夠加載,允許頁面完成渲染,並掃描最特定的頁面而不是廣泛的首頁。
- 資源僅在互動後載入
- 連結是臨時的或需要身份驗證。
- 頁面使用受保護的串流或 blob URL。
- 可見項目是 CSS 背景、縮略圖或生成的預覽。
常見問題
我可以從任何網站下載所有檔案嗎?
不。GrabAll 可以整理瀏覽器可用的文件和連結。它不會繞過身份驗證、付費牆、DRM、私人儲存或技術訪問限制。
我應該先過濾什麼?
從檔案類型開始,然後使用檔案大小或影像解析度來移除圖示、縮圖和無關資源。
GrabAll 可以掃描多頁嗎?
是的。對於已在瀏覽器中打開的頁面使用打開標籤掃描,或對準備好的列表使用導入 URL 掃描,這取決於可用的工作流程和方案。
我應該對每一批使用 ZIP 導出嗎?
ZIP 匯出對於有組織的批次很有用,但當檔案非常大或需要保持分開時,普通下載可能更好。