
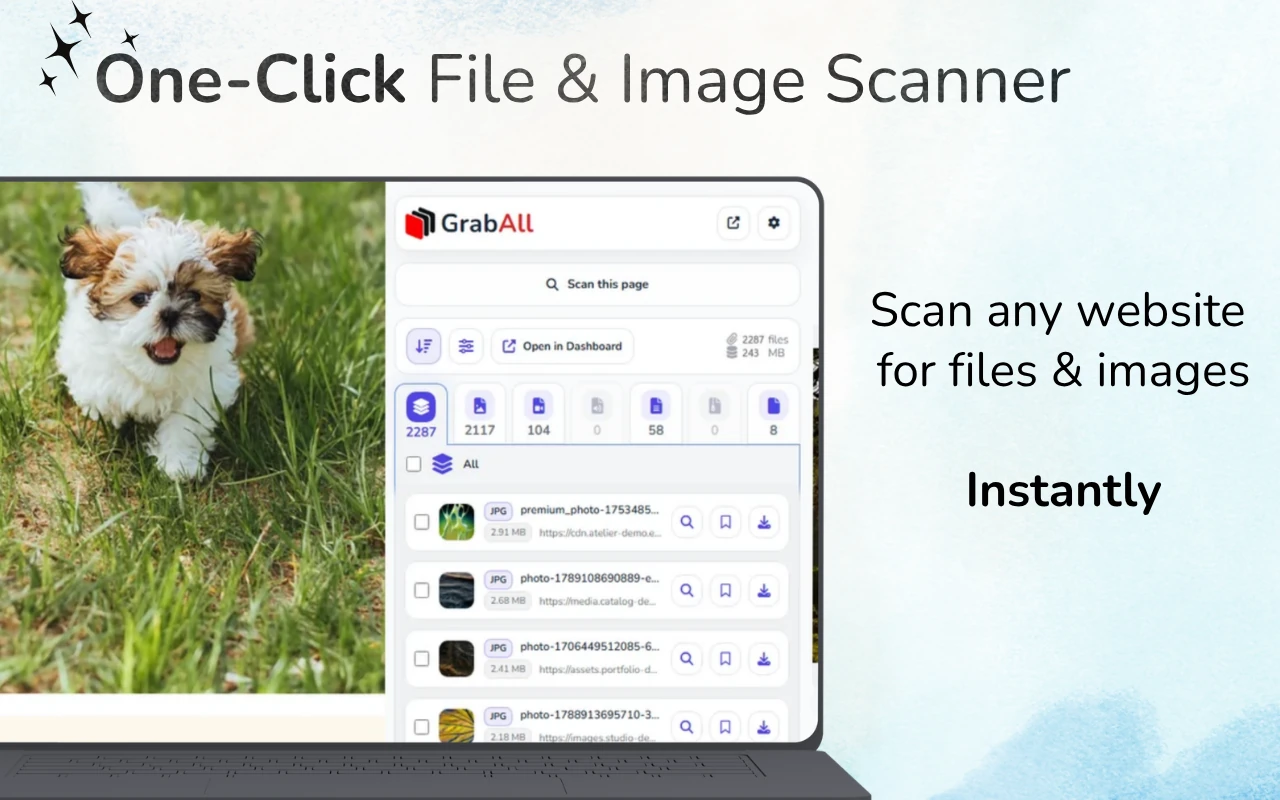
Rýchla odpoveď: Pre živú webovú stránku skenujte pomocou GrabAll a skopírujte detekované odkazy na súbory. Pre uložený HTML alebo skopírovaný zdrojový kód ho vložte do Bulk File URL Extractor. Zadajte základnú URL, keď zdroj obsahuje relatívne odkazy.
Rozhodnite sa medzi skenovaním stránky a parsovaním vloženého HTML
Skenovanie načítanej webovej stránky môže nájsť súbory dostupné v prehliadači, zatiaľ čo online extraktor číta iba HTML alebo text, ktorý vložíte. Vyberte metódu, ktorá zodpovedá vášmu východiskovému bodu, a potom si pred ich použitím na stiahnutie prezrite výsledné URL.
Kde sa v HTML objavujú URL súborov
Bežné odkazy používajú href, zatiaľ čo obrázky a médiá bežne používajú src. Responsívne obrázky môžu uviesť niekoľkých kandidátov v srcset. Knižnice pre lazy-loading často ukladajú skutočné URL do data-src, data-original alebo vlastných dátových atribútov.
Štýly a inline CSS môžu odkazovať na pozadia cez url(). Surová textová forma môže tiež obsahovať kompletné URL, ktoré nie sú pripojené k žiadnemu HTML elementu.
- href odkazy
- atribúty src a poster
- kandidáti srcset a data-srcset
- CSS hodnoty url() a surové absolútne URL
Správne vyriešiť relatívne cesty
Hodnota ako ../files/report.pdf má význam iba vzhľadom na stránku, odkiaľ pochádza HTML. Poskytnite pôvodnú URL stránku ako základ, aby extraktor mohol previesť relatívne cesty na úplné adresy.
Protokolovo-relatívne odkazy začínajúce // zvyčajne zdedia HTTPS na zabezpečenej stránke. Cesty relatívne ku koreňu začínajúce / používajú aktuálny pôvod webovej stránky.
- Zachovať pôvodnú URL stránky zdroja
- Použite to ako základnú URL
- Normalizujte protokolovo-relatívne a koreňovo-relatívne cesty
- Pred použitím zoznamu si skontrolujte vyriešené domény
Filtrovať kandidátske URL podľa zámeru
Nie každý URL v zdrojovom kóde je sťahovateľný súbor. Stránky obsahujú navigačné odkazy, API, analytiku, fonty, skripty, štýlové súbory a sledovacie parametre. Filtrovať podľa relevantných prípon a skontrolovať nejednoznačné URL.
Pre obrázky zahrňte moderné formáty ako WebP a AVIF. Pre dokumenty zvážte PDF, DOCX, XLSX, CSV, PPTX a archívy podľa úlohy.
HTML zdroj verzus vykreslená stránka
Skopírovaný zdroj predstavuje iba to, čo ste poskytli. Môže chýbať obsah vložený po spustení JavaScriptu, obsah načítaný po rolovaní alebo URL adresy vytvorené počas interakcie.
Použite offline extraktor pre zdrojové úryvky, exportovaný HTML, šablóny e-mailov a kontrolu kódu. Použite rozšírenie GrabAll pre živú rendrovanú stránku a pracovné postupy v kontexte prehliadača.
Overte pred stiahnutím
Odstráňte duplicity zo zoznamu, skontrolujte domény a otestujte malý vzorok. Zhodujúca sa prípona v URL nezaručuje, že odpoveď je platná alebo že máte povolenie ju používať.
Vyhnite sa automatickému požiadavke veľkých nerevidovaných zoznamov. Validácia zabraňuje nefunkčným odkazom, nežiaducim sledovacím endpointom a zbytočnému zaťaženiu.
Často kladené otázky
Dokáže extraktor riešiť relatívne odkazy ../?
Áno, keď zadáte pôvodnú URL stránky ako základnú adresu.
Zahŕňa extrakcia HTML obrázky zo srcset?
Nástroj GrabAll kontroluje bežné atribúty zdrojov a responzívnych obrázkov, vrátane kandidátov srcset.
Prečo niektoré súbory zo živej stránky chýbajú v skopírovanom HTML?
JavaScript ich môže pridať po načítaní počiatočného HTML. Použite rozšírenie živého prehliadača pre renderovaný a dynamicky načítaný obsah stránky.
Sú všetky extrahované URL bezpečné na stiahnutie?
Nie. Skontrolujte domény, typy súborov, povolenia a malý vzor pred použitím zoznamu výsledkov.
GrabAll prehľadáva stránku a prináša obrázky, dokumenty, médiá a iné stiahnuteľné súbory do jedného prehľadného zoznamu, aby ste si mohli vybrať presne, čo chcete uložiť.