
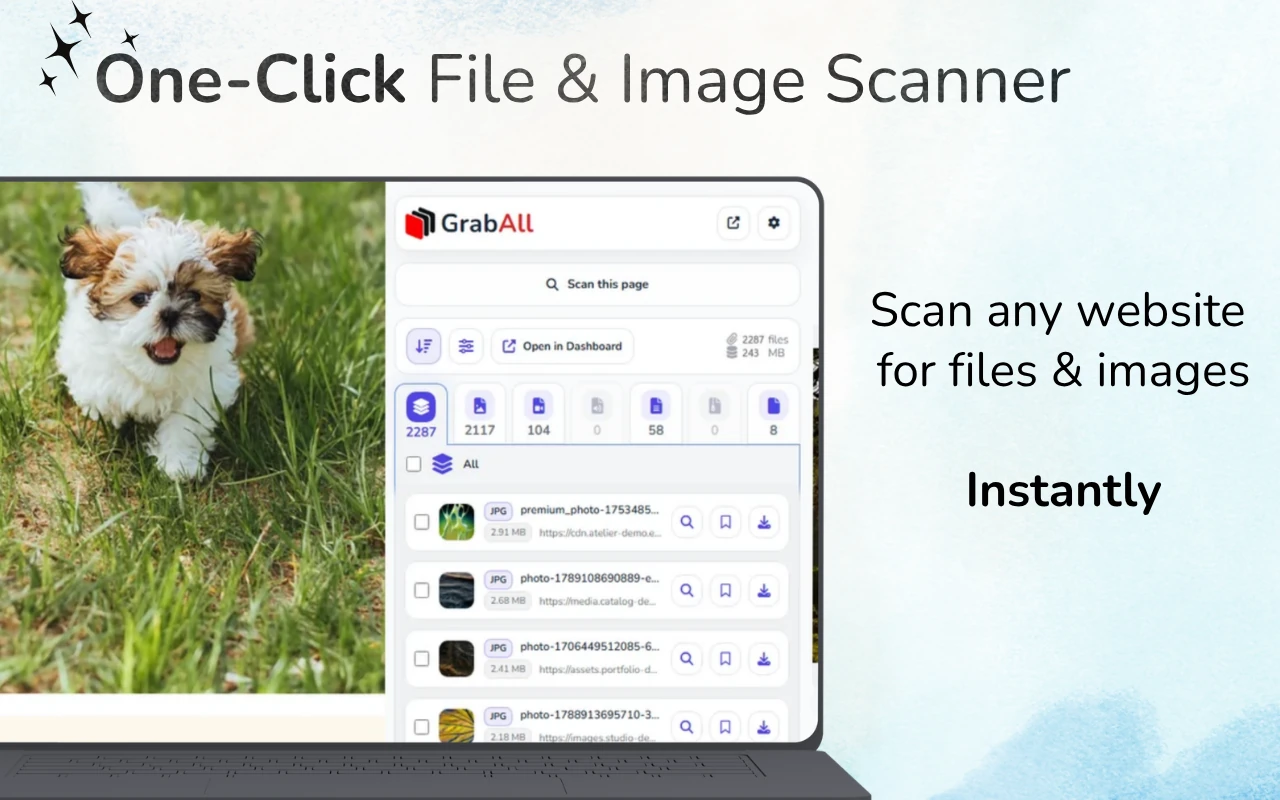
Швидка відповідь: Для живої вебсторінки проскануйте за допомогою GrabAll і скопіюйте виявлені посилання на файли. Для збереженого HTML або скопійованого вихідного коду вставте його в Bulk File URL Extractor. Надайте базову URL-адресу, якщо джерело містить відповідні посилання.
Вибрати між скануванням сторінки та парсингом вставленого HTML
Сканування завантаженої вебсторінки може знайти файли, доступні в браузері, тоді як онлайн-екстрактор читає тільки HTML або текст, який ви вставляєте. Виберіть метод, що відповідає вашій вихідній точці, а потім перевірте отримані URL перед їх використанням для завантаження.
Де URL файлів відображаються в HTML
Звичайні посилання використовують href, тоді як зображення та мультимедіа зазвичай використовують src. Адаптивні зображення можуть містити кілька варіантів у srcset. Бібліотеки з ледачим завантаженням часто зберігають реальні URL у data-src, data-original або у власних атрибутах data.
Таблиці стилів та вбудований CSS можуть посилатися на фони через url(). Сирий текст також може містити повні URL-адреси, які не пов'язані з HTML-елементом.
- посилання href
- атрибути src та poster
- кандидати srcset та data-srcset
- CSS url() значення та чисті абсолютні URL
Правильно розв'язати відносні шляхи
Значення, як ../files/report.pdf, має сенс лише відносно сторінки, з якої походить HTML. Вкажіть URL оригінальної сторінки як базовий, щоб екстрактор міг перетворити відносні шляхи на повні адреси.
Посилання, що відносні до протоколу і починаються з //, зазвичай наслідують HTTPS на захищеній сторінці. Шляхи, відносні до кореня і що починаються з /, використовують поточну адресу сайту.
- Зберігайте URL оригінальної сторінки джерела
- Використовуйте її як базову URL
- Нормалізуйте протокольно-відносні та коренево-відносні шляхи
- Перегляньте вирішені домени перед використанням списку
Фільтруйте URL-адреси кандидатів за наміром
Не кожен URL у вихідному коді є завантажуваним ресурсом. Сторінки містять навігаційні посилання, API, аналітику, шрифти, скрипти, стилі та параметри відстеження. Фільтруйте за релевантними розширеннями та перевіряйте сумнівні URL.
Для зображень включайте сучасні формати, такі як WebP і AVIF. Для документів розгляньте PDF, DOCX, XLSX, CSV, PPTX та архіви відповідно до завдання.
HTML-джерело проти відображеної сторінки
Копійоване джерело відображає лише те, що ви надали. Він може пропускати ресурси, вставлені після завантаження JavaScript, контент, завантажений після прокрутки, або URL, створені під час взаємодії.
Використовуйте офлайн-екстрактор для вихідних фрагментів, експортованого HTML, шаблонів електронної пошти та перегляду коду. Використовуйте розширення GrabAll для робочих процесів з живим рендерингом сторінки та браузерного контексту.
Перевірте перед завантаженням
Дедуплювати список, перевірити домени та протестувати невелику вибірку. Відповідне розширення в URL не гарантує, що відповідь дійсна або що ви маєте право її використовувати.
Уникайте автоматичного запиту великих неперевірених списків. Валідація запобігає битим посиланням, небажаним трекінг-ендпоінтам та зайвому навантаженню.
Поширені запитання
Чи може екстрактор розв'язувати відносні посилання ../?
Так, коли ви надаєте оригінальну URL-адресу сторінки як базову адресу.
Чи включає витягування HTML зображення srcset?
Інструмент GrabAll перевіряє загальні атрибути джерела та адаптивних зображень, включаючи кандидати srcset.
Чому деякі файли живої сторінки відсутні у скопійованому HTML?
JavaScript може додавати їх після початкового завантаження HTML. Використовуйте розширення для браузера в режимі реального часу для відображеного та динамічно завантаженого контенту сторінки.
Чи всі отримані URL безпечні для завантаження?
Ні. Перед використанням списку результатів перегляньте домени, типи файлів, дозволи та невелику вибірку.
GrabAll сканує сторінку та збирає зображення, документи, медіа та інші завантажувані файли в один зрозумілий список, щоб ви могли вибрати саме те, що хочете зберегти.